我这篇博客有很多低级的东西,大佬勿喷。
0. 事故现场
9 月 30 日凌晨,我有个服务器突然挂了。
这里把排查记录、原因、修复方式以及一些教训写下来,也方便后面复习一些命令的使用。
症状如下:
- ping IP是通的
- TCP 22 能建立
- SSH 客户端显示
Connection established - 然后卡在 banner exchange,永远等不到登录提示
这种情况通常只有一个原因:系统资源耗尽了,服务器卡的受不了,腾不出手接收 ssh 请求。
没办法只能重启,登上去之后看了看系统基本状态:
# 查看当前进程数和负载
$ ps -e --no-headers | wc -l
1145

$ uptime
23:10:15 up 4 min,  1 user,  load average: 0.35, 0.89, 0.42
现在是正常了,用 sar 看历史数据:
sar -q是专门查看 CPU 队列与系统负载的子命令,-f /var/log/sa/sa30表示读取当月 30 号的历史采样日志。- 平均负载的统计对象是「可运行态 + 不可中断阻塞态」的进程,数值越接近 CPU 物理核心数,CPU 饱和度越高;持续大幅超过核心数则代表 CPU 出现拥堵。
runq-sz持续高于 CPU 核心数,是 CPU 性能瓶颈的典型信号;blocked持续偏高通常对应磁盘 I/O 瓶颈。
# 查看 9月30日凌晨的进程和负载情况
$ sar -q -f /var/log/sa/sa30 | grep "00:1"
00:10:01    runq-sz  plist-sz   ldavg-1   ldavg-5  ldavg-15   blocked
00:10:01          3      1452      0.21      0.19      0.18         0
00:17:11         96     25462     77.23    102.45     51.38         0
00:24:43         48     25274     47.38     88.56     67.45         1
00:30:01 14 25265 13.64 62.45 66.89 0| 字段名 | 英文全称 | 中文含义 |
|---|---|---|
| 00:10:01 | - | 系统性能采样的时间点 |
| runq-sz | Run Queue Size | 运行队列长度:等待 CPU 调度的就绪态进程数量,仅包含等待 CPU 时间片的进程,不包含阻塞、休眠进程 |
| plist-sz | Process List Size | 进程列表总大小:系统内所有状态的进程总数,包含运行、就绪、阻塞、休眠、僵尸等全部状态的进程 |
| ldavg-1 | Load Average 1 minute | 过去 1 分钟的系统平均负载 |
| ldavg-5 | Load Average 5 minutes | 过去 5 分钟的系统平均负载 |
| ldavg-15 | Load Average 15 minutes | 过去 15 分钟的系统平均负载 |
| blocked | Blocked Processes | 阻塞进程数:因等待 I/O、锁、外设等资源而无法进入运行队列的进程数量 |
00:17 时的数据:
- plist-sz: 25,462(进程/任务数)
- ldavg-1: 77.23(1分钟平均负载)
- 正常情况下 plist-sz 只有 1100 左右
再看内存和 swap:
$ sar -r -f /var/log/sa/sa30 | grep "00:1"
00:10:01  kbmemfree   ...  %memused  kbswpfree  %swpused
00:10:01    7549232         1.23%     4194300      0.00%
00:17:11     788520        99.87%           0    100.00%
00:24:43     788644        99.87%           0    100.00%
00:30:01   14580716        98.01%     1048576     75.00%
sar -r是专门查看内存使用统计的子命令,统计维度覆盖物理内存、交换分区、缓存缓冲区三大类。- Linux 内存机制中,
kbbuffers和kbcached是系统为提升 I/O 性能主动占用的缓存,属于可回收内存,进程需要时可以快速释放,因此不能仅用%memused判断内存不足,实际可用内存约等于kbmemfree + kbbuffers + kbcached。 %swpused持续升高是物理内存不足的核心信号:当物理内存吃紧时,系统会把不活跃的内存页置换到交换分区,频繁的换入换出会大幅降低系统性能。
| 字段名 | 英文全称 | 中文含义 |
|---|---|---|
| 00:10:01 | - | 系统性能采样的时间点 |
| kbmemfree | Kilobytes Memory Free | 空闲物理内存容量,单位为 KB,指完全未被占用的物理内存 |
| kbmemused | Kilobytes Memory Used | 已使用物理内存容量,单位为 KB,包含进程占用、缓冲区、缓存的总和 |
| %memused | Percentage Memory Used | 物理内存使用率,即已用物理内存占总物理内存的百分比 |
| kbbuffers | Kilobytes Buffers | 缓冲区内存容量,单位为 KB,主要用于块设备(磁盘)I/O 的临时缓冲 |
| kbcached | Kilobytes Cached | 缓存内存容量,单位为 KB,主要用于缓存文件系统数据,加速文件读写 |
| kbswpfree | Kilobytes Swap Free | 空闲交换分区容量,单位为 KB,即未被使用的虚拟内存空间 |
| kbswpused | Kilobytes Swap Used | 已使用交换分区容量,单位为 KB |
| %swpused | Percentage Swap Used | 交换分区使用率,即已用交换空间占总交换空间的百分比 |
00:17 时:
- 内存使用:99.87%(内存几乎全满,注意,这里为了隐藏一些信息,我没有展示真实的内存容量信息。)
- Swap 使用:100%(4 GiB 也满了)
服务器这么大的内存居然被吃光了。而且这一情况在 00:10 时完全不存在,所以我们就拿到了一个发生的时间段:00:10-00:17
而且这不是第一次。9 月 18 日也发生过类似的事故。
1. 最开始的线索:pigz
重启前系统日志里有大量这样的警告:
$ journalctl --boot=-1 --since "2026-09-30 00:10" | grep "shell level"
Sep 30 00:17:23 bash: warning: shell level (1000) too high, resetting to 1
Sep 30 00:17:24 bash: warning: shell level (1000) too high, resetting to 1
Sep 30 00:17:25 bash: warning: shell level (1000) too high, resetting to 1
...(数千条)
SHLVL 是 shell 的嵌套层级,这里的shell level对应环境变量 SHLVL,正常情况下不会超过 10。到 1000 说明 bash 在疯狂递归调用自己。
- 这里的日志一直
warning 1000是因为Bash内置了安全阈值,当嵌套层级达到1000时,会被判定出现了无限递归,会把层级重置为1,避免栈溢出导致进程崩溃。 - 这里几千条重复
warning说明系统中存在持续的、快速的、无限的、递归的Shell调用。由此我们可以知道,之前的内存爆了就是由于这种shell一直无限的生成导致的,那么我们考虑以下几种可能。- 脚本自调用:某个脚本里面,没有终止条件地调用了自己,然后又调用自己,一直不干正事,就在那一直调用。比如有一个脚本
run.sh,里面内容里面又写着/path/to/run.sh,也有可能就是./run.sh,执行后就会无限递归生成子进程调用自己。 - 配置文件循环加载:用户环境配置文件(
~/.bashrc、~/.bash_profile)或系统配置(/etc/profile)中,错误地循环source了自身,或者两个配置文件互相 source,每次启动 bash 都会触发嵌套。 bash被污染/替换:给bash命令设置了别名,或者定义了名为bash的函数,内部又调用了bash命令,导致每次执行 bash 都会无限嵌套。- 定时任务/自启动脚本有bug:crontab 或开机自启服务中,存在有递归 bug 的脚本,到点触发后就持续在后台疯跑。
- 脚本自调用:某个脚本里面,没有终止条件地调用了自己,然后又调用自己,一直不干正事,就在那一直调用。比如有一个脚本
看看当时的进程树(从日志重建):
systemd
  └─ bash /data/scripts/download.sh
      └─ bash -c pigz file.txt
          └─ bash -c pigz -
              └─ bash -c pigz -
                  └─ bash -c pigz -
                      └─ ... (无限递归)
问题出在 pigz 上。检查这个文件:
$ ls -lh /usr/bin/pigz
-rwxr-xr-x 1 root root 7 Sep 18 17:47 /usr/bin/pigz
只有 7 字节?正常的 pigz 应该是几十 KB 的 ELF 可执行文件。这个-h就是以一种自适应的方法展示他的文件大小。
| 参数 | 作用 | 例子 |
|---|---|---|
-l | 详细信息:权限、所有者、大小、时间 | ls -l |
-a | 显示隐藏文件(. 开头) | ls -a |
-h | 文件大小用人类易读单位 KB/MB/GB | ls -lh |
-t | 按修改时间排序,新的在前 | ls -lt |
-r | 反向排序 | ls -ltr |
-S | 按文件大小排序,大的在前 | ls -lS |
-R | 递归列出子目录 | ls -R |
-d | 查看目录本身,不展开目录内容 | ls -ld /tmp |
-i | 显示 inode 号 | ls -li |
-F | 文件名后加类型标记,例如 / 目录、* 可执行文件 | ls -F |
-1 | 一行显示一个文件 | ls -1 |
$ file /usr/bin/pigz
/usr/bin/pigz: ASCII text

$ cat /usr/bin/pigz
pigz -

$ wc -c /usr/bin/pigz
7 /usr/bin/pigz文件内容只有一行:pigz -,这就是递归的根源!
2. 递归的机制
当一个程序不是 ELF 可执行文件,也不是 #! 开头的脚本时,kernel 会把它当作 shell 脚本交给 /bin/sh 执行。
所以当你执行 pigz file.txt 时:
1. kernel 读取 /usr/bin/pigz
2. 发现内容是 "pigz -"
3. 启动 /bin/sh 执行这行文本
4. sh 执行:pigz -
5. 通过 PATH 再次找到 /usr/bin/pigz
6. 回到步骤 1
7. 无限的pigz在调用shell去找pigz并执行这个错误的pigz,OOM出现
每次递归都会:
- 创建新的 bash 进程
- 分配内存
- SHLVL + 1
最终结果就是进程数暴增、内存耗尽。
3. 不止 pigz
既然 pigz 被改坏了,其他常用命令呢?
$ ls -lh /usr/bin/git /usr/bin/unpigz
-rwxr-xr-x 1 root root 7 Sep 18 17:47 /usr/bin/git
-rwxr-xr-x 1 root root 7 Sep 18 17:47 /usr/bin/unpigz

$ cat /usr/bin/git
git -

$ cat /usr/bin/unpigz
unpigz -
git 和 unpigz 也是!而且修改时间都是 2026-09-18 17:47。
再看 /usr/local/bin:
- /usr/bin:一般放操作系统/发行版提供的系统程序
- /usr/local/bin:一般放管理员自己安装的软件、第三方程序、自己编译安装的程序,以及自定义 wrapper
- 区别:PATH里面你可以定义这些bin的寻找顺序,谁先找到就用谁,由此可能出现两个bin里面的命令/软件版本冲突,甚至你如果放了更多的自定义bin目录比如conda目录,这种情况更加会容易出现,搞半天你还不知道为啥跑失败了,因为谁能记得住版本的细微差别(我不是说gcc 8.0和gcc 11.0分不出来)。
$ find /usr/local/bin -type f -size -100c -exec ls -lh {} \;
-rwxr-xr-x 1 root root 6 Sep 18 17:47 /usr/local/bin/gcc
-rwxr-xr-x 1 root root 6 Sep 18 17:47 /usr/local/bin/x86_64-pc-linux-gnu-gcc
-rwxr-xr-x 1 root root 11 Sep 18 17:47 /usr/local/bin/samtools
-rwxr-xr-x 1 root root 8 Sep 18 17:47 /usr/local/bin/tabix
用 file 命令批量检查:
- 这里
100c就是找100 bytes的文件 exec是对每一个find到的普通文件进行file操作{}代表当前找到的文件\代表exec命令到这里结束,如果没有这个符号,由于find -exec要求你必须给一个结束标志;,如果没有\,就会报错find: missing argument to -exec,\在这里起到转义;的功能,防止shell吧;当做一个命令分隔符使用了。- 你还可以用
';'来转义
- 你还可以用
- 我们还可以使用
+:这代表尽可能批量去执行找到的,如file a b c,使之更加高效。
find /usr/local/bin -type f -size -100c -exec file {} +$ find /usr/local/bin -type f -size -100c -exec file {} \;
/usr/local/bin/gcc: ASCII text, 6 bytes
/usr/local/bin/x86_64-pc-linux-gnu-gcc: ASCII text, 6 bytes
/usr/local/bin/samtools: ASCII text, 11 bytes
/usr/local/bin/tabix: ASCII text, 8 bytes看看内容:
$ cat /usr/local/bin/gcc
gcc -

$ cat /usr/local/bin/samtools
samtools -

$ cat /usr/local/bin/tabix
tabix -
甚至之前删除的某个 Conda 环境(IReNA)里也有类似问题:
$ cat /data/conda/envs/IReNA/bin/R
R -

$ cat /data/conda/envs/IReNA/bin/python3
python3 -
所有这些文件的修改时间都集中在:2026-09-18 17:47
$ stat /usr/bin/pigz | grep Modify
Modify: 2026-09-18 17:47:22.536489012 +0800

$ stat /usr/local/bin/gcc | grep Modify
Modify: 2026-09-18 17:47:22.891234567 +0800
这不是巧合,9 月 18 日 17:47 那个时间点一定发生了什么。
4. 9 月 18 日发生了什么
那是第一次事故。用 sar 看看当时的情况:
$ sar -q -f /var/log/sa/sa18 -s 17:00:00 -e 20:00:00
17:10:01       8199     97.23
17:20:01       8201     96.87
17:30:01       8209     97.01
17:40:01       8201     96.54
17:50:01       8214     97.12
18:00:01      12336    102.45
18:10:01      13948    118.67
18:20:01      14932    125.34
18:30:01      15710    132.89
18:40:01      16457    145.23
18:50:01      17245    156.78
19:00:01      20049    178.45
19:10:01      21298    189.23
关键发现:
- 17:10 时进程数已经约 8200(正常是 1100)
- 17:47 是文件被改写的时间
- 但 17:10 时异常就已经开始了
所以 17:47 不是"事故开始时间",而是"文件被破坏的时间点"。
当时除了文件被改写,还有两个脚本在疯狂运行:
$ ps aux | grep check2.sh | wc -l
3847

$ ps aux | grep process_ready_bams | wc -l
2156
check2.sh 原本是个监控脚本:
#!/usr/bin/env bash
echo "total=$(ps -e --no-headers | wc -l)"
echo "run_pipeline=$(pgrep -fc run_pipeline.sh 2>/dev/null || echo 0)"
echo "process_ready_bams=$(pgrep -fc process_ready_bams 2>/dev/null || echo 0)"
但它自己形成了递归(可能是通过调用损坏的其他命令)。
后来把它改成了安全的 no-op 版本,即
no-operation,什么都不做,直接exit并且加了 immutable 属性防止被修改,即不可变属性。也就是这里的
----i---------------,i就代表immutable
$ cat /tmp/check2.sh
#!/bin/bash
exit 0

$ lsattr /tmp/check2.sh
----i--------------- /tmp/check2.sh
process_ready_bams.sh 是一个正常的后台任务脚本:
while true; do
    # 处理 BAM 文件
    samtools view ...
    samtools sort ...
    sleep 600
done
它本身没问题,但调用了 samtools,而 samtools 已经被改坏了,所以也成了递归链的一部分。
systemd journal 里还能看到当时的情况:
$ journalctl --boot=-2 --since "2026-09-18 17:00" | grep -E "(check2|samtools|OOM)"
Sep 18 17:47:15 systemd[1]: Starting check2.sh...
Sep 18 17:52:34 kernel: Out of memory: Killed process 15234 (bash)
Sep 18 18:03:12 kernel: Out of memory: Killed process 18956 (samtools)
Sep 18 18:15:47 kernel: Out of memory: Killed process 21043 (bash)
OOM killer 在拼命杀进程,但新进程产生的速度比杀掉的还快。
5. 根本原因推测
回想 9 月 18 日那天,我在让 AI 帮忙安装生信工具包。
AI 很可能通过 SSH 管道执行了类似这样的命令:
echo "
for tool in gcc git samtools tabix pigz unpigz R Rscript python3 make; do
    echo \"\$tool -\" > /usr/local/bin/\$tool
    chmod +x /usr/local/bin/\$tool
    cat >> /usr/local/bin/\$tool << 'EOF'
#!/bin/bash
exec /conda/bin/\$tool \"\$@\"
EOF
done
" | ssh root@server bash
AI 的本意可能是创建 wrapper 脚本,让系统级命令指向 Conda 环境中的工具。
- 这里
echo这么多\是为了防止把”当做第一个echo "后面的那个”当做一对,实际上这整个是为了ssh后再执行的。
脚本逻辑是:
- 先写入
tool -作为占位符 - 再追加完整的 wrapper 内容
但我在执行到一半时按了 Ctrl+C。
结果:
echo "$tool -" >已执行(覆盖了原文件)- 后面的
cat >>未执行(完整内容没写入) - 留下一堆只有一行
xxx -的文件
为什么是管道命令特别危险?
SSH 管道的数据传输是流式的:
本地脚本 → 本地 SSH 缓冲 → 网络 → 远程 SSH 缓冲 → 远程 bash stdin中断时:
- 本地停止发送
- 但远程会继续执行已接收的部分
- 后面的内容永远不会到达
如果脚本是个 for 循环,中断可能发生在循环的第 7 次迭代,结果就是前 7 个工具被改坏,后面的保持原样。
这也解释了为什么只有部分文件被改写。
6. 9 月 30 日为什么又出问题
9 月 18 日事故后,我发现了这个问题,并修复了部分文件,并反复检查还有没有:
perm /111:找权限,user group other里面权限只要有一个是1(执行权限)就算,/就是这个功能r = read 读 4 w = write 写 2 x = execute 执行 1
size -1k:文件必须小于1kbread -r:不要把\当做转义符处理,即原样读取内容,然后读取变量放到fbasename:把f=/usr/local/bin/x86_64-pc-linux-gnu-gcc变成name=x86_64-pc-linux-gnu-gcc,因为我们文件里面是pigz -,而不是usr/local/bin/pigz -最后判断文件内容是不是
/xxx/bin/{tool}里面的内容是{tool} -的格式,如果是,就输出{tool}: /xxx/bin/{tool} -的格式2>/dev/null是为了丢掉error,不想看报错0 = 标准输入 stdin 1 = 标准输出 stdout 2 = 标准错误 stderr
for d in /usr/bin /usr/local/bin; do
    find "$d" -maxdepth 1 -type f -perm /111 -size -1k |
    while read -r f; do
        name=$(basename "$f")
        if [ "$(cat "$f" 2>/dev/null)" = "$name -" ]; then
            echo "$f: $name -"
        fi
    done
done
发现
- gcc ✓
- samtools ✓
- tabix ✓
但漏掉了 git、unpigz。
可能是因为:
- 我不常用 unpigz(通常只用 pigz 压缩)
- 检查时主要看了
/usr/local/bin,漏掉了/usr/bin - 文件太多,没有全部检查
9 月 30 日凌晨,某个下载任务脚本调用了 unpigz 或 pigz,触发了递归,系统再次崩溃。
⭐7. 修复过程
7.1 恢复损坏的文件
git:
dnf:地下城?错,这个就是让软件包管理器把git重新安装一遍,dnf即Dandified YUM,是新一代的yum,比rpm更加高级
$ dnf reinstall -y git
Last metadata expiration check: 2:15:34 ago on Mon Sep 30 21:00:12 2026.
Dependencies resolved.
Package                    Arch        Version                Repository        Size
Reinstalling:
 git                       x86_64      2.43.0-1.el8           baseos            160 k
...
Complete!

$ git --version
git version 2.43.0

$ file /usr/bin/git
/usr/bin/git: ELF 64-bit LSB executable, x86-64, dynamically linked
恢复成功,git 现在是正常的 ELF 文件。
pigz 和 unpigz:
本来想用 dnf reinstall pigz:
$ dnf reinstall -y pigz
Errors during downloading metadata for repository 'appstream':
  - Status code: 403 for http://vault.centos.org/8-stream/AppStream/x86_64/os/repodata/repomd.xml
Error: Failed to download metadata for repo 'appstream': Cannot download repomd.xml
CentOS 8 Stream 的 vault 仓库返回 403,安装失败。
替代方案:从 Conda 环境复制
先找一个正常的 pigz:
$ find /data -name pigz -type f -executable 2>/dev/null | head -3
/data/xxx/miniconda/envs/xxx/bin/pigz
/data/conda/envs/base/bin/pigz
/data/xxx/anaconda3/bin/pigz

$ file /data/xxx/miniconda/envs/xxx/bin/pigz
/data/xxx/miniconda/envs/xxx/bin/pigz: ELF 64-bit LSB executable

$ /data/xxx/miniconda/envs/xxx/bin/pigz --version
pigz 2.8
这个是正常的,复制过去:
$ cp /data/xxx/miniconda/envs/xxx/bin/pigz /usr/bin/pigz
$ chmod 755 /usr/bin/pigz
$ ln -sf pigz /usr/bin/unpigz
验证:
$ file /usr/bin/pigz
/usr/bin/pigz: ELF 64-bit LSB executable, x86-64, dynamically linked

$ pigz --version
pigz 2.8

$ ls -lh /usr/bin/unpigz
lrwxrwxrwx 1 root root 5 Sep 30 23:15 /usr/bin/unpigz -> pigz

$ echo "test" | pigz | unpigz
test
完美。unpigz 是 pigz 的符号链接,压缩解压都正常(简单的test传给pigz压缩在unpigz解压,最后又变成了test)。
7.2 清理残留证据文件
把 /usr/local/bin 中异常的 gcc 相关文件移到证据目录:
$ mkdir -p /root/incident_evidence_20260918

$ find /usr/local/bin -name "*.recursive.*" -o -name "x86_64-pc-linux-gnu-gcc*"
/usr/local/bin/gcc.recursive.bak
/usr/local/bin/gcc.recursive.disabled
/usr/local/bin/x86_64-pc-linux-gnu-gcc
/usr/local/bin/x86_64-pc-linux-gnu-gcc-11.2.0

$ mv /usr/local/bin/gcc.recursive.* /root/incident_evidence_20260918/
$ mv /usr/local/bin/x86_64-pc-linux-gnu-gcc* /root/incident_evidence_20260918/

$ ls -lh /root/incident_evidence_20260918/
total 24K
-rwxr-xr-x 1 root root 6 Sep 18 17:47 gcc.recursive.bak
-rwxr-xr-x 1 root root 6 Sep 18 17:47 gcc.recursive.disabled
-rwxr-xr-x 1 root root 6 Sep 18 17:47 x86_64-pc-linux-gnu-gcc
-rwxr-xr-x 1 root root 6 Sep 18 17:47 x86_64-pc-linux-gnu-gcc-11.2.0
保留作为证据,mtime 都是 2026-09-18 17:47。
7.3 全面检查
检查所有小于 100 字节的可执行文件:
$ find /usr/bin /usr/local/bin -type f -size -100c -exec file {} \; 2>/dev/null
/usr/bin/.placeholder: ASCII text, 1 byte
/usr/local/bin/.placeholder: ASCII text, 1 byte
只剩下两个占位符文件(这是系统正常的),其他都是正常的 ELF 文件。
再检查是否有其他 ASCII 文本伪装成可执行文件:
$ find /usr/bin /usr/local/bin -type f -executable -exec file {} \; | grep -v ELF | grep -v script | head -10
/usr/bin/.placeholder: ASCII text
/usr/local/bin/.placeholder: ASCII text
确认没有遗漏,所有该是 ELF 的都已经恢复了。
最后验证关键命令:
- 这个
&&和;有一点点区别,前者要求两个命令同时成功,后者是依次执行。
| 参数 | 作用 | 例子 |
|---|---|---|
-i | 忽略大小写 | grep -i error log.txt |
-v | 反向筛选,排除匹配行 | grep -v ELF |
-n | 显示行号 | grep -n error log.txt |
-r | 递归搜索目录 | grep -r error /var/log |
-R | 递归搜索,且跟随符号链接 | grep -R error /var/log |
-l | 只显示包含匹配内容的文件名 | grep -l error *.log |
-L | 只显示不包含匹配内容的文件名 | grep -L error *.log |
-c | 只显示匹配行数量 | grep -c error log.txt |
-o | 只输出匹配到的部分 | grep -o 'ELF.*' file.txt |
-w | 按完整单词匹配 | grep -w gcc file.txt |
-x | 整行完全匹配 | grep -x 'gcc -' file.txt |
-E | 使用扩展正则表达式 | `grep -E ‘gcc |
-F | 按普通字符串匹配,不解析正则 | grep -F 'gcc -' file.txt |
-P | 使用 Perl 正则 | grep -P '\d{4}-\d{2}-\d{2}' file.txt |
-A N | 显示匹配行以及后面 N 行 | grep -A 3 error log.txt |
-B N | 显示匹配行以及前面 N 行 | grep -B 3 error log.txt |
-C N | 显示匹配行前后各 N 行 | grep -C 3 error log.txt |
-q | 静默模式,只看退出状态,不输出 | grep -q error log.txt |
-s | 不显示文件不存在/无法读取等错误 | grep -s error *.log |
-h | 多文件搜索时不显示文件名 | grep -h error *.log |
-H | 强制显示文件名 | grep -H error *.log |
-a | 把二进制文件当文本处理 | grep -a ELF binary |
-I | 忽略二进制文件 | grep -I error * |
-m N | 找到 N 次后停止 | grep -m 1 error log.txt |
-z | 以 NUL 而不是换行作为记录分隔符 | grep -z ... |
$ for cmd in git gcc pigz unpigz samtools tabix; do
    echo -n "$cmd: "
    which $cmd && file $(which $cmd) | grep -o "ELF.*"
done

git: /usr/bin/git
ELF 64-bit LSB executable, x86-64, dynamically linked
gcc: /usr/bin/gcc
ELF 64-bit LSB executable, x86-64, dynamically linked
pigz: /usr/bin/pigz
ELF 64-bit LSB executable, x86-64, dynamically linked
unpigz: /usr/bin/unpigz
ELF 64-bit LSB executable, x86-64, dynamically linked
samtools: /usr/local/bin/samtools
ELF 64-bit LSB executable, x86-64, dynamically linked
tabix: /usr/bin/tabix
ELF 64-bit LSB executable, x86-64, dynamically linked
全部恢复。
8. 为什么没有设置监控
最开始我加了完整性检查和进程监控,但后来觉得:
- 资源占用虽然很小,但不想要任何后台任务
- 这次事故应该是偶然的
- 已经修复了所有损坏文件,不太可能再发生
所以最后把监控都删除了。
如果以后再出现类似问题,可以考虑:
- 用
auditd监控关键文件的写入操作 - 定期检查关键命令是否是正常 ELF 文件
- 进程数量超过阈值时触发告警
9. 教训
9.1 管道命令要小心
不要通过 SSH 管道执行复杂的批量操作,尤其是会覆盖系统文件的操作。
更安全的做法:
# 先写到临时文件
cat > /tmp/wrapper_$tool << 'EOF'
#!/bin/bash
exec /conda/bin/$tool "$@"
EOF

# 验证文件完整
if [ -s /tmp/wrapper_$tool ]; then
    # 原子性地移动
    mv /tmp/wrapper_$tool /usr/local/bin/$tool
    chmod +x /usr/local/bin/$tool
fi但其实最关键做法就是不要动/usr/bin和/usr/local/bin的东西
9.2 中断后要全面检查
如果中断了一个批量操作,不要只检查"看起来有问题"的文件。
应该:
# 检查最近修改的小文件
find /usr/bin /usr/local/bin -type f -mmin -10 -size -1k

# 检查是否有异常的文本文件
find /usr/bin /usr/local/bin -type f -exec file {} \; | grep -v ELF
9.3 关键文件要保护
可以考虑对关键系统命令加 immutable 属性:
chattr +i /usr/bin/git
chattr +i /usr/bin/pigz
但要注意:
- 正常的系统更新也会失败
- 升级前需要先
chattr -i
9.4 备份很重要
在执行可能影响系统的操作前,先备份关键文件:
cp -p /usr/bin/{git,pigz,gcc} /root/backup/10. 技术细节补充
10.1 为什么是 “xxx -” 而不是其他内容
这可能是 AI 生成的脚本中的占位符写法。
- 在很多命令中表示"从 stdin 读取",所以 pigz - 的意思本来应该是"从标准输入读取数据并压缩"。
但当这行文本被 shell 解释执行时,它会通过 PATH 再次查找 pigz 命令,如果找到的还是同一个损坏的文件,就形成了递归。
我们可以手动验证这个机制:
# 创建一个测试目录
$ mkdir /tmp/test_recursion
$ cd /tmp/test_recursion

# 创建一个"损坏"的命令
$ echo "testcmd -" > testcmd
$ chmod +x testcmd

# 把当前目录加到 PATH 最前面
$ export PATH="/tmp/test_recursion:$PATH"

# 执行这个命令(注意:这会快速消耗资源,立即 Ctrl+C)
$ timeout 2 ./testcmd 2>&1 | head -20
bash: warning: shell level (1000) too high, resetting to 1
bash: warning: shell level (1000) too high, resetting to 1
...
可以看到和我们服务器上一样的递归警告。
清理测试:
$ cd ~
$ rm -rf /tmp/test_recursion
$ export PATH=$(echo $PATH | sed 's|/tmp/test_recursion:||')
10.2 SHLVL 的含义
SHLVL 是 shell 的嵌套层级。可以这样观察:
$ echo $SHLVL
1

$ bash -c 'echo $SHLVL'
2

$ bash -c 'bash -c "echo $SHLVL"'
3

$ bash -c 'bash -c "bash -c \"echo \$SHLVL\""'
4
正常情况下:
- 登录 shell:SHLVL=1
- 在 shell 中启动子 shell:SHLVL=2
递归调用会导致 SHLVL 不断增加:
# 模拟递归(小心!会快速增长)
$ (bash -c 'for i in {1..10}; do bash -c "echo SHLVL=\$SHLVL"; done')
SHLVL=2
SHLVL=2
SHLVL=2
...
bash 在达到 1000 时会重置并输出警告:
bash: warning: shell level (1000) too high, resetting to 1这是 bash 的自我保护机制,但重置后递归还会继续。
10.3 为什么 SSH 登录不了
用 ss 命令看 TCP 连接状态:
$ ss -tn | grep :22
ESTAB  0  0  server_ip:22  client_ip:54321
连接是 ESTAB(已建立)状态,但卡在那里了。
当系统内存和进程数耗尽时:
# 当时的资源状态(从 sar 重建)
$ free -h
              total        used        free      shared  buff/cache   available
Mem:           754G        752G        788M         12G        1.2G         200M
Swap:          4.0G        4.0G          0B
此时:
- kernel 仍能处理网络包(所以 ping 通,TCP 能建立)
- 但 sshd 无法 fork 出新进程处理登录
# sshd 的日志(事故时)
$ journalctl -u sshd --boot=-1 --since "00:15" --until "00:20"
Sep 30 00:17:23 sshd[12345]: Accepted connection from client_ip port 54321
Sep 30 00:17:23 sshd[12345]: error: fork: Cannot allocate memory
Sep 30 00:17:45 sshd[12346]: Accepted connection from client_ip port 54322
Sep 30 00:17:45 sshd[12346]: error: fork: Cannot allocate memory
即使 fork 成功,也可能因为内存不足无法分配 PTY:
Sep 30 00:18:12 sshd[12389]: error: pty_allocate: Cannot allocate memory最终表现就是:
- 客户端:
Connection established后卡住 - 服务端:sshd 无法创建会话
- 结果:永远等不到登录提示
验证当前系统可用资源(恢复后):
$ cat /proc/sys/kernel/pid_max
4194304

$ ps -e --no-headers | wc -l
1145

$ echo "当前进程数占 PID 空间的比例: $(echo "scale=2; 1145/4194304*100" | bc)%"
当前进程数占 PID 空间的比例: 0.02%
正常情况下进程数占用不到 0.1%,事故时达到了 0.6%(25,462 / 4,194,304)。
10.4 内存是怎么被吃光的
每个 bash 进程大约占用:
$ ps aux | grep bash | head -1 | awk '{print $6}'
3456

# 单位是 KB,转换成 MB
$ echo "scale=2; 3456/1024" | bc
3.38
单个 bash 进程约 3.38 MB。
如果有 25,462 个 bash 进程:
$ echo "scale=2; 25462 * 3.38 / 1024" | bc
84.03
bash 本身占用约 84 GB。
但还有进程栈、文件描述符、内核数据结构等开销:
# 查看进程限制
$ ulimit -a | grep -E "open files|max user processes|stack size"
open files                      (-n) 1048576
max user processes              (-u) 772700
stack size              (kbytes, -s) 8192
每个进程:
- 栈:8 MB
- 文件描述符表:若干 KB
- task_struct 等内核结构:~1-2 KB
粗略计算(25,462 个进程):
$ echo "scale=2; 25462 * (3.38 + 8 + 0.1) / 1024" | bc
285.73
约 285 GB,这还没算上其他正常进程和系统开销。
加上正常的生信任务(一些任务本身就占几十 GB 内存),754 GB 被吃光就不奇怪了。
11. 总结
这次事故的完整链条:
9月18日 AI 帮忙安装工具
    ↓
通过 SSH 管道执行批量脚本
    ↓
脚本先写 "xxx -" 占位符,再写完整内容
    ↓
执行到一半被 Ctrl+C 中断
    ↓
多个系统命令只剩下 "xxx -"
    ↓
修复了部分文件,但漏掉了 pigz/unpigz
    ↓
9月30日 某任务调用 unpigz
    ↓
触发 pigz 无限递归
    ↓
bash 进程暴增,内存耗尽
    ↓
SSH 无法登录,只能重启
核心问题不是某个程序的 bug,而是:
- 脚本设计不当(先覆盖文件,再写内容)
- 操作被中断(没有原子性保证)
- 检查不彻底(漏掉了部分损坏文件)
最终的解决办法也很直接:
- 恢复所有损坏的文件
- 全面检查确保没有遗漏
- 以后避免用管道执行危险操作
754 GiB 内存能被吃光,不是因为某个程序占用太多,而是因为几万个 bash 进程同时存在。
这次事故提醒我:系统维护不能只看"当前有问题的地方",而要全面检查"可能被影响的所有地方"。
希望对大家有所帮助!还是挺容易出现的,尤其是AI ssh服务器帮你搞的时候。
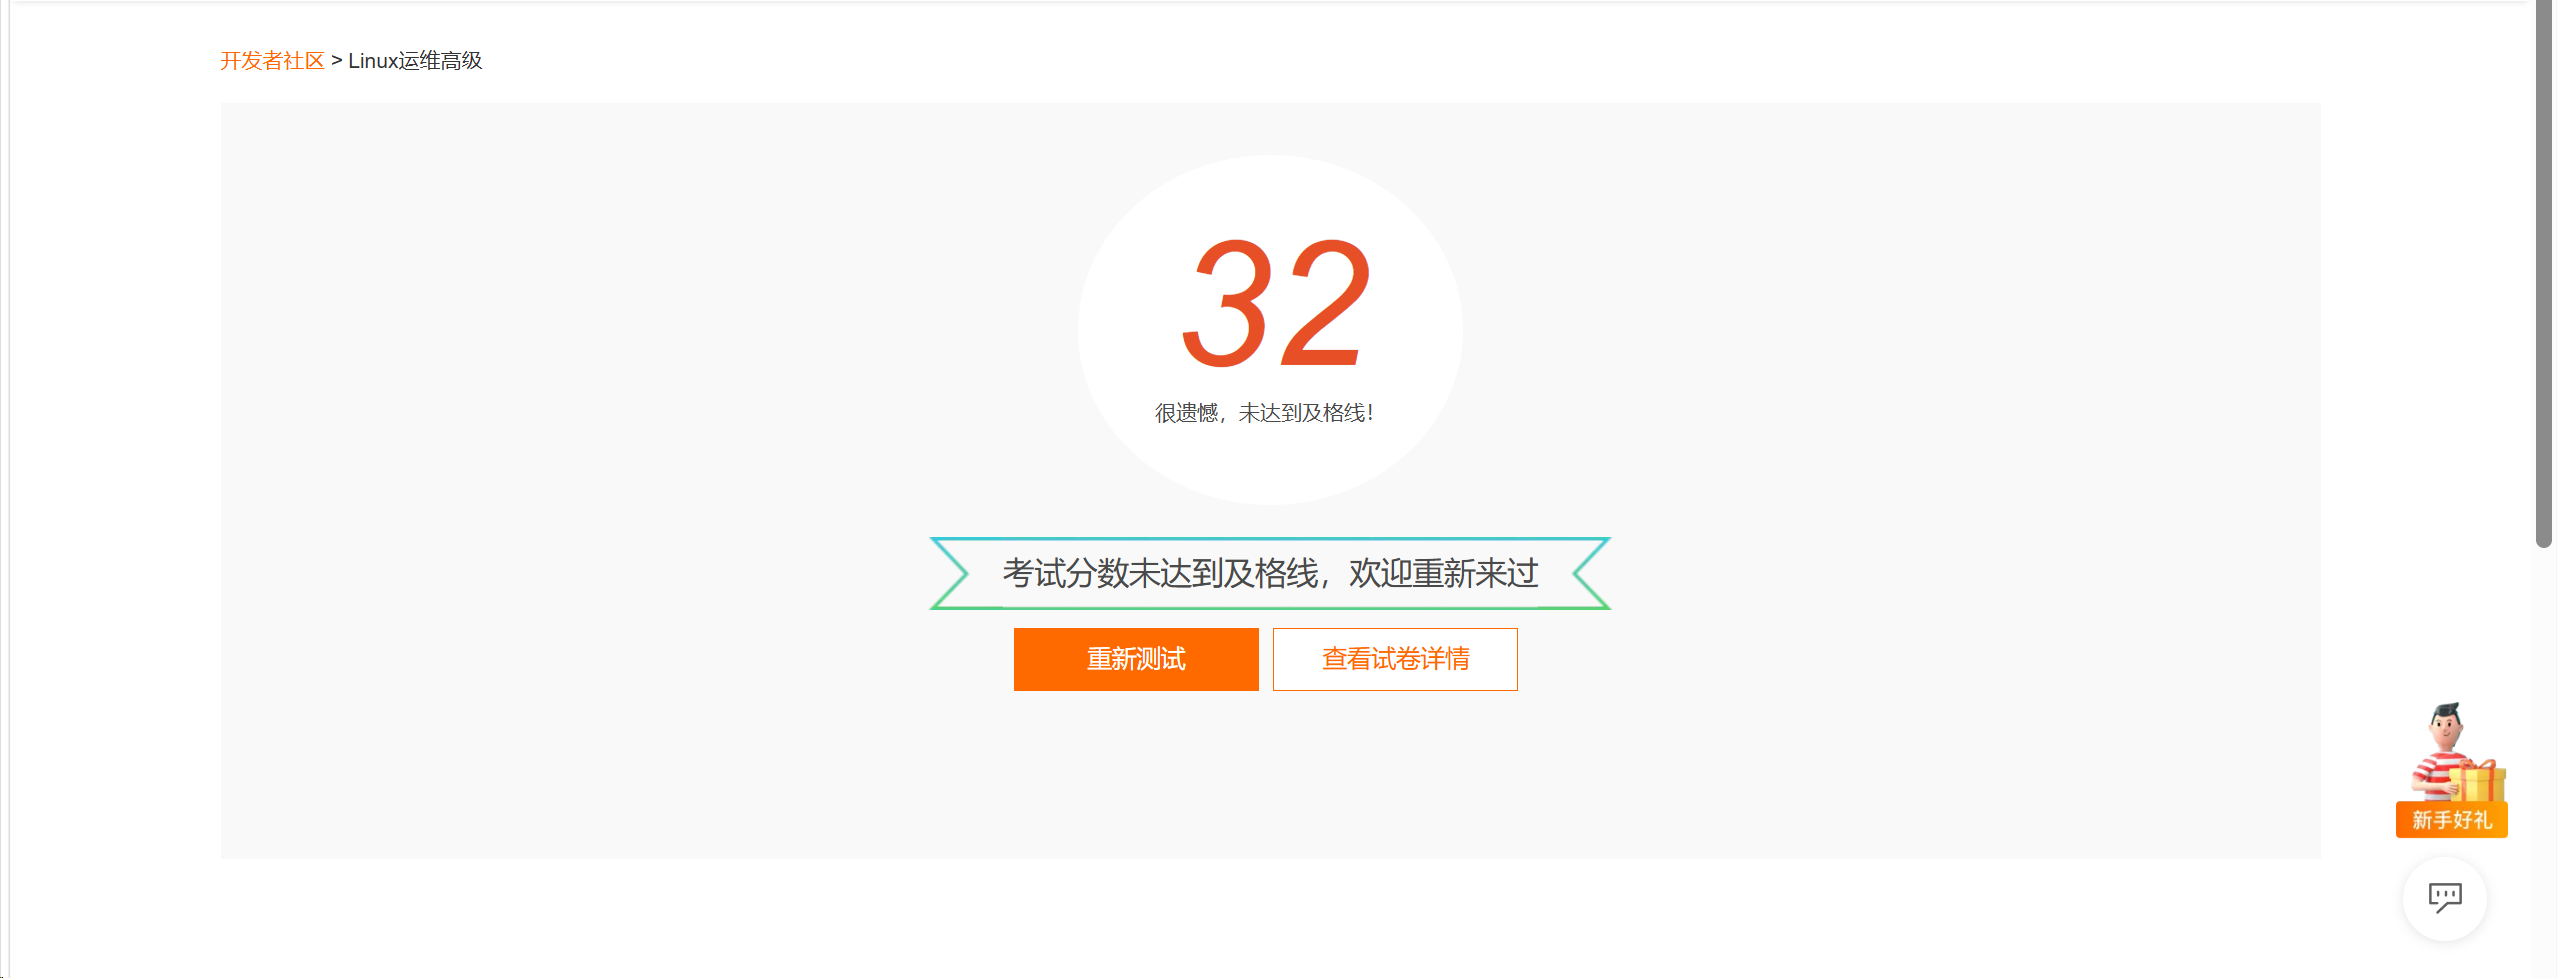
图为零基础自测linux高级运维试卷,正确题数 8/25,没绷住。今日立誓,要学好linux!
- 又在立flag咯… 2026.10.1 June